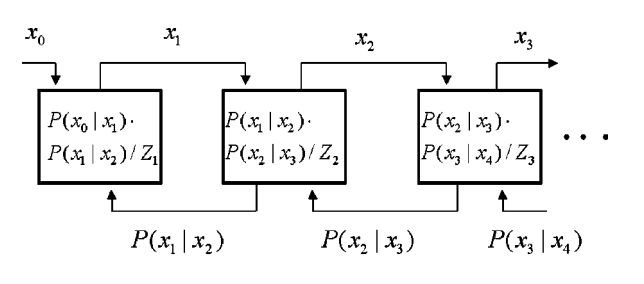
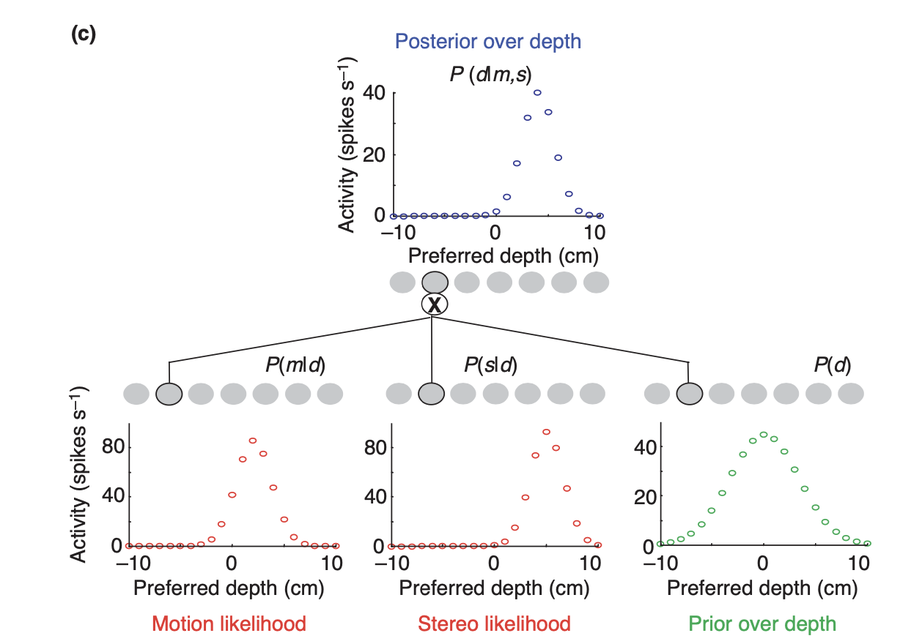
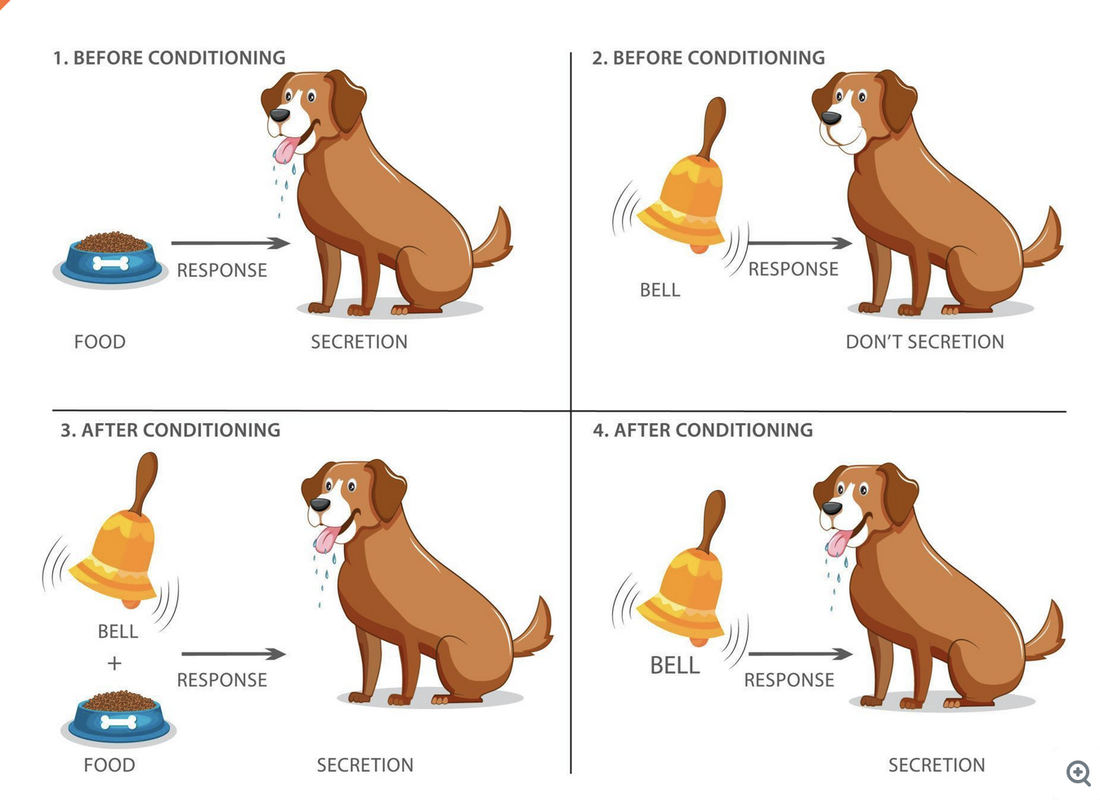
Pregunta computacional: ¿qué cantidad está aprendiendo el animal y con qué regla la actualiza?
Parte I · Aprender valores
Rescorla–Wagner (1972): aprender de la sorpresa
ΔVi = αi β ( λ − Σj Vj )
Vifuerza asociativa del estímulo i: cuánto US prediceλmagnitud del US en este ensayo (λ = 0 si no hay US)ΣjVjpredicción conjunta de todos los estímulos presentesλ − ΣVsorpresa (error de predicción): lo que pasó menos lo esperadoαi, βsaliencia del CS y del US: tasa de aprendizaje
Sin sorpresa no hay aprendizaje, aunque CS y US se repitan juntos
Los estímulos presentes compiten por una cantidad limitada de predicción (λ)
Es una regla de un solo ensayo a la vez: no necesita recordar el pasado, solo V
Rescorla, R. A., & Wagner, A. R. (1972). A theory of Pavlovian conditioning: Variations in the effectiveness of reinforcement and nonreinforcement. En Classical Conditioning II, 64–99.
Parte I · Aprender valores
Rescorla–Wagner en acción: un estímulo interactivo
Prueba
V ← V + α(λ·US − V), un ensayo a la vez. La línea punteada es la solución analítica con reforzamiento continuo: Vn = λ[1 − (1−α)n]. Con reforzamiento parcial, el US aparece con probabilidad P(US) y V persigue un blanco que cambia de ensayo a ensayo.
Parte I · Aprender valores
Estímulos compuestos: competir por la predicción interactivo
Protocolo
Cada ensayo presenta un subconjunto de estímulos ({A}, {B} o {A,B}) con o sin US. Todos los presentes se actualizan con la misma sorpresa λ − (VA + VB). “+” = con US, “−” = sin US.
Kamin (1969): si A ya predice el US, B no aprende nada aunque se empareje con el US muchas veces. No es la contigüidad lo que enseña, es la sorpresa.
Kamin, L. J. (1969). Predictability, surprise, attention, and conditioning. Rescorla & Wagner (1972).
Parte I · Aprender valores
Rescorla–Wagner es la regla delta
Define el error cuadrático de un ensayo: E = ½ (λ − Σj Vj xj)², con xj = 1 si el estímulo está presente
Descenso por gradiente: ΔVi = −η ∂E/∂Vi = η (λ − ΣV) xi
Es exactamente Rescorla–Wagner con η = αiβ
La misma regla que el LMS de Widrow–Hoff (1960) y que una neurona lineal entrenada por error
Consecuencia: lo que importa no es cuántas veces coinciden CS y US, sino cuánto se equivocó la predicción
Parte I · Aprender valores
Lo que Rescorla–Wagner no captura
El tiempo dentro del ensayo: RW ve “ensayos”; un animal ve un CS que dura 2 s y un US que llega después. ¿Cuándo esperar la recompensa?
Condicionamiento de segundo orden: B → A, y A ya predice el US; B adquiere valor sin US presente. En RW, un ensayo B→A sin US extingue
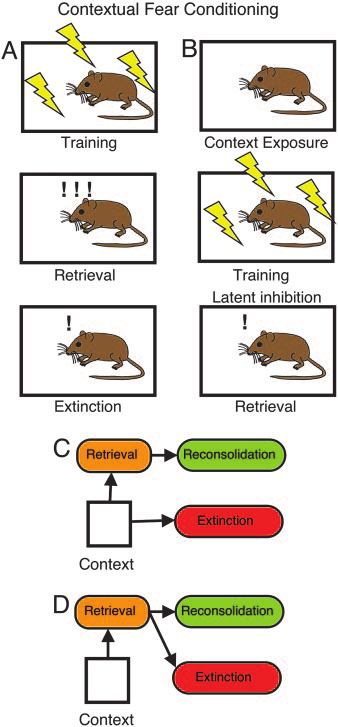
Recuperación espontánea, renovación, reinstalación: la extinción “borra” V, pero la respuesta regresa
Inhibición latente: un CS pre-expuesto sin US aprende más lento, aunque en RW V = 0 antes y después
Dos extensiones, dos partes de la clase
Tiempo → aprendizaje por diferencias temporales (TD): predecir la recompensa futura en cada instante, no solo en el ensayo
Estructura → causas latentes: el animal no solo aprende V, aprende en qué situación está, y las situaciones no se borran
Marr otra vez: el nivel computacional pregunta qué problema resuelve el aprendizaje. Si el mundo cambia, “borrar” es mala estrategia; “inferir que algo cambió” es mejor.
Parte I · Aprender valores
El valor de un instante: descuento temporal interactivo
Definimos el valor de un estado como la recompensa futura esperada, descontada:
γ ∈ [0, 1): una recompensa dentro de k pasos vale γk
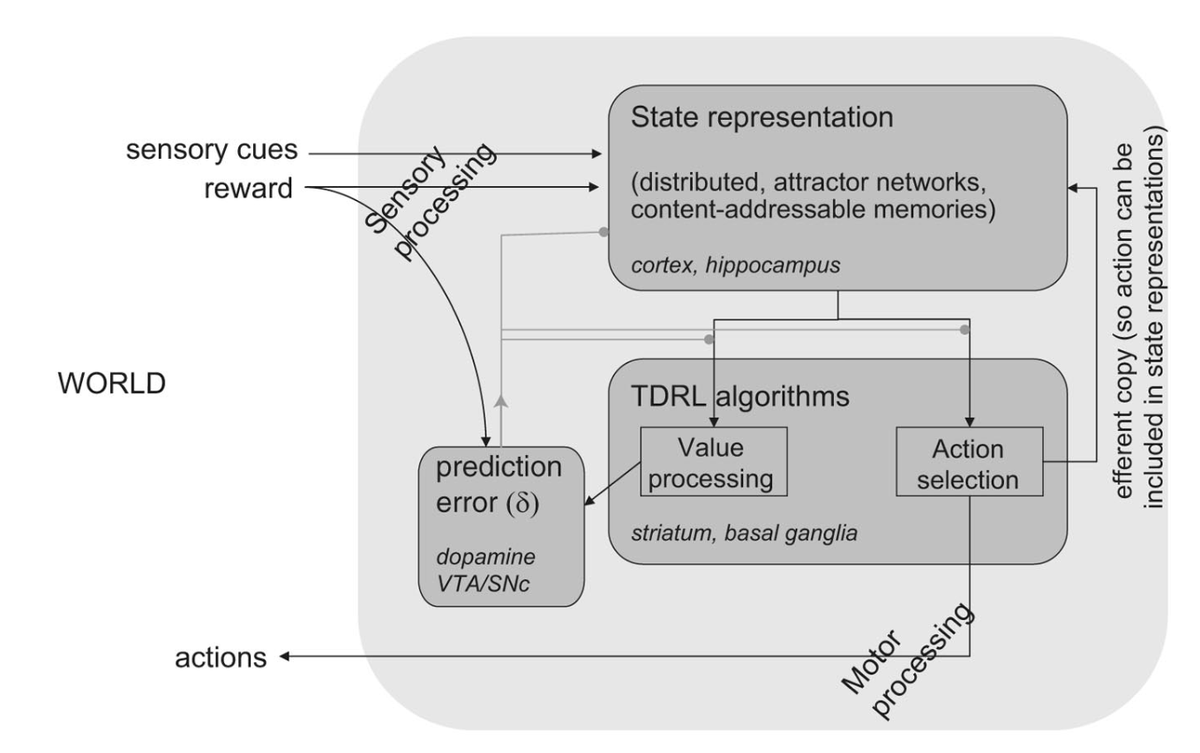
Las neuronas dopaminérgicas del VTA/SNc disparan como δt: al principio responden a la recompensa; con el aprendizaje la respuesta se mueve al estímulo que la predice, y una recompensa omitida produce una pausa. Lo vemos paso a paso en las siguientes diapositivas.
CS en t = 2, recompensa (R = 1) al llegar a t = 8. En cada paso: δ = R + γ·V(t+1) − V(t), y V(t) se mueve α·δ. Fíjate en qué paso aparece el primer δ distinto de cero en cada ensayo.
Parte I · Aprender valores
TD a lo largo de muchos ensayos interactivo
Prueba
Izquierda: dentro de un ensayo (eje t = instante). CS en t = 2. Arriba V(t), abajo δ(t) del ensayo actual. Derecha: entre ensayos (eje = número de ensayo): δ en el CS y en la recompensa. Los presets que comparan dos valores dibujan las dos corridas con colores distintos.
Parte I · Aprender valores
Dopamina = error de predicción de recompensa interactivo
Schultz, Dayan & Montague (1997): monos con jugo como recompensa
Antes de aprender: la neurona dispara con el jugo
Después de aprender: dispara con el CS y ya no con el jugo
Jugo omitido: pausa (disparo por debajo de la línea base) justo cuando el jugo debía llegar
Los paneles los genera el modelo TD: tasa = línea base + δ(t); cada fila del raster es un ensayo con disparos Poisson
Prueba
Schultz, W., Dayan, P., & Montague, P. R. (1997). A neural substrate of prediction and reward. Science, 275, 1593–1599.
Parte I · Aprender valores
Del valor a la acción: Q-learning interactivo
Prueba
Q(s,a) ← Q(s,a) + α[r + γ maxa' Q(s',a') − Q(s,a)]. El agente parte de la esquina inferior izquierda, la meta (+1) está arriba a la derecha y el gris es pared. El color de cada celda es maxa Q (su valor); la flecha, la acción codiciosa; la línea, la trayectoria del último episodio.
El mismo error de predicción δ que en el condicionamiento ahora también enseña qué hacer: evaluar y actuar son dos caras del mismo algoritmo (actor–crítico, Q-learning, SARSA).
Watkins, C. J. C. H., & Dayan, P. (1992). Q-learning. Machine Learning, 8, 279–292. Sutton & Barto (2018), cap. 6.
Parte II · Aprender estructura
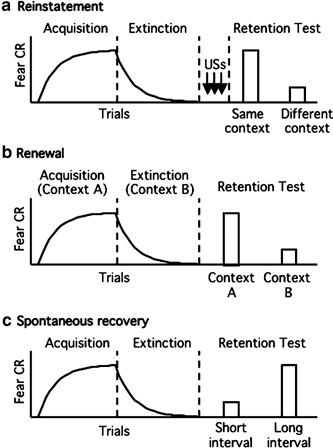
Lo que se observa vs. lo que predice RL recuperación espontánea, re-adquisición rápida, renovación, reinstalación
Lo que se observa (esquema de los datos): tras la extinción, un descanso de 24 h devuelve parte de la respuesta; re-aprender toma menos ensayos que la primera vez.
Tres formas en que la respuesta extinta regresa: reinstalación (US solo), renovación (cambio de contexto), recuperación espontánea (tiempo).
Lo que predice Rescorla–Wagner / TD: un solo valor V que la extinción borra.
Prueba
Parte II · Aprender estructura
El mundo para un animal vs. un agente RL
El mundo no está perfectamente especificado
El animal tiene que inferir la estructura del mundo
¿Cuáles son los estados del mundo?
¿Existen cambios en las “contingencias”?
Dos procesos importantes en RL
Evaluar el valor del estado (Parte I)
Reconocer el estado (Parte II)
Redish, A., Jensen, S., Johnson, A., & Kurth-Nelson, Z. (2007). Reconciling reinforcement learning models with behavioral extinction and renewal. Psychological Review, 114, 784–805.
Parte II · Aprender estructura
¿Cómo se generan las observaciones?
Identificar distintas estructuras que pueden explicar las observaciones
¿Sobre qué estados opera RL?
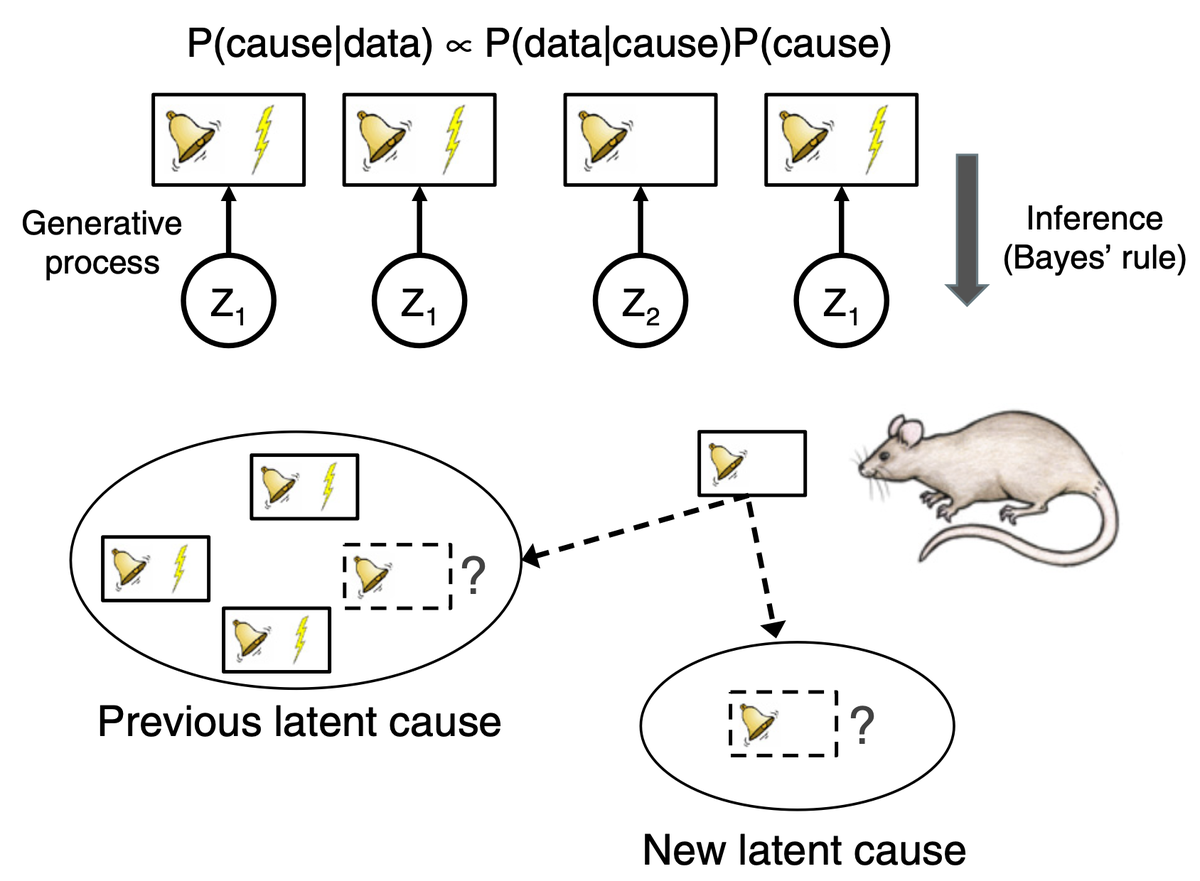
Tres hipótesis para un tono y una descarga:
I: el tono causa la descarga
II: una variable latente y causa ambos
III: tono y descarga tienen causas independientes
Parte II · Aprender estructura
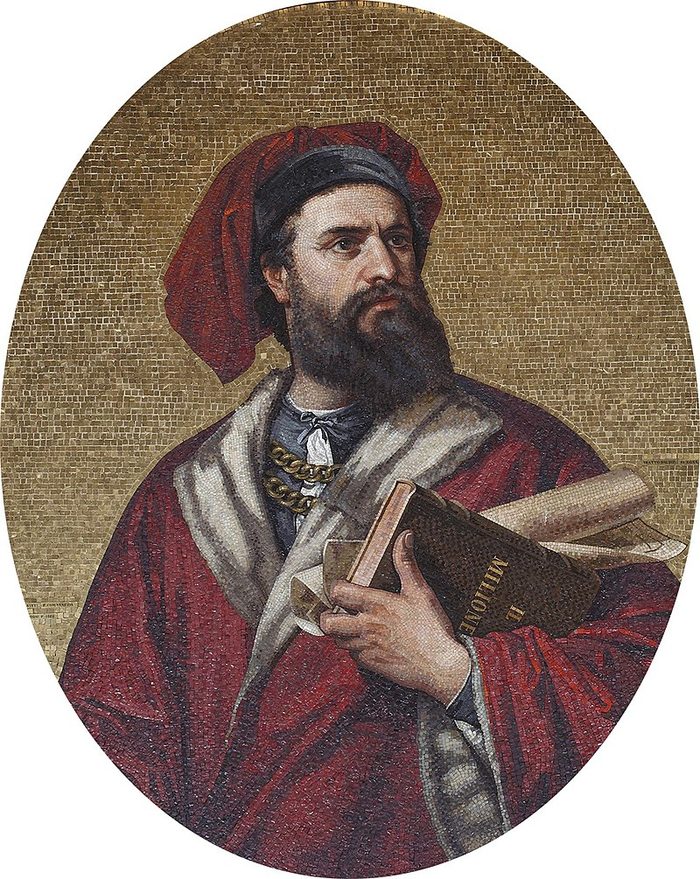
Marco Polo y los unicornios
“Los unicornios no son como te los contaron.”
Una observación nueva se asigna a la causa conocida más parecida… hasta que la evidencia justifica inventar una causa nueva.
Parte II · Aprender estructura
Inferencia Bayesiana de las causas
No se trata de aprender asociaciones entre estímulos y recompensas
Se trata de inferir causas ocultas de las observaciones
Modelo generativo:
Se muestrea una causa
De la causa muestreada se muestrean las observaciones
El animal trata de “invertir” el modelo para inferir la causa dadas las observaciones
Observaciones parecidas tienden a venir de la misma causa
Gershman, S. J., Norman, K. A., & Niv, Y. (2015). Discovering latent causes in reinforcement learning. Current Opinion in Behavioral Sciences, 5, 43–50.
Parte II · Aprender estructura
Mezclas de causas: ¿cuántas situaciones hay? interactivo
Cada causa es una distribución sobre observaciones (aquí, una Gaussiana en 2D). Asignar observaciones a causas = clustering
σ (verosimilitud): qué tan ancha es cada causa; cuánta variabilidad tolera el animal dentro de una situación
α (prior): el “apetito por novedad”: qué tan fácil se abre una causa nueva. Es el parámetro del Proceso del Restaurante Chino (siguiente diapositiva)
Los mismos datos admiten varias explicaciones (“una situación que cambia” o “varias situaciones”); α y σ deciden cuál gana
Datos:
Inferir:
Prueba
Clic en el lienzo para agregar observaciones. “En línea” asigna cada observación una sola vez, en orden de llegada, como un animal que no puede volver atrás. Gershman & Blei (2012).
Parte II · Aprender estructura
Proceso del Restaurante Chino interactivo
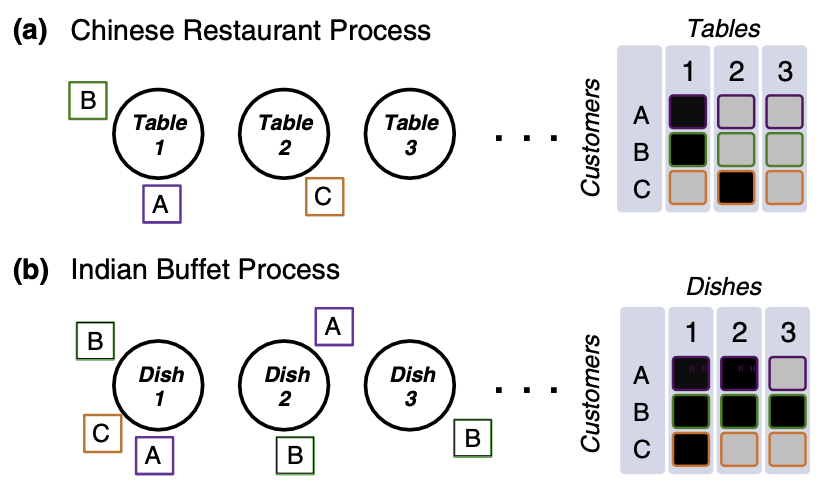
¿Cómo elegimos cuántas causas existen? Cada “cliente” (observación) se sienta en una mesa ocupada con probabilidad proporcional a su ocupación, o abre una mesa nueva con probabilidad ∝ α.
mk: clientes en la mesa k · K+: mesas ocupadas · α: concentración
Los ricos se hacen más ricos: las mesas grandes atraen más clientes
El número esperado de mesas crece como α·log(n)
Intercambiable: el orden de llegada no cambia la probabilidad de la partición
Prueba
Gershman, S. J., & Blei, D. M. (2012). A tutorial on Bayesian nonparametric models. Journal of Mathematical Psychology, 56(1), 1–12.
Parte II · Aprender estructura
¿Más de una causa latente a la vez?
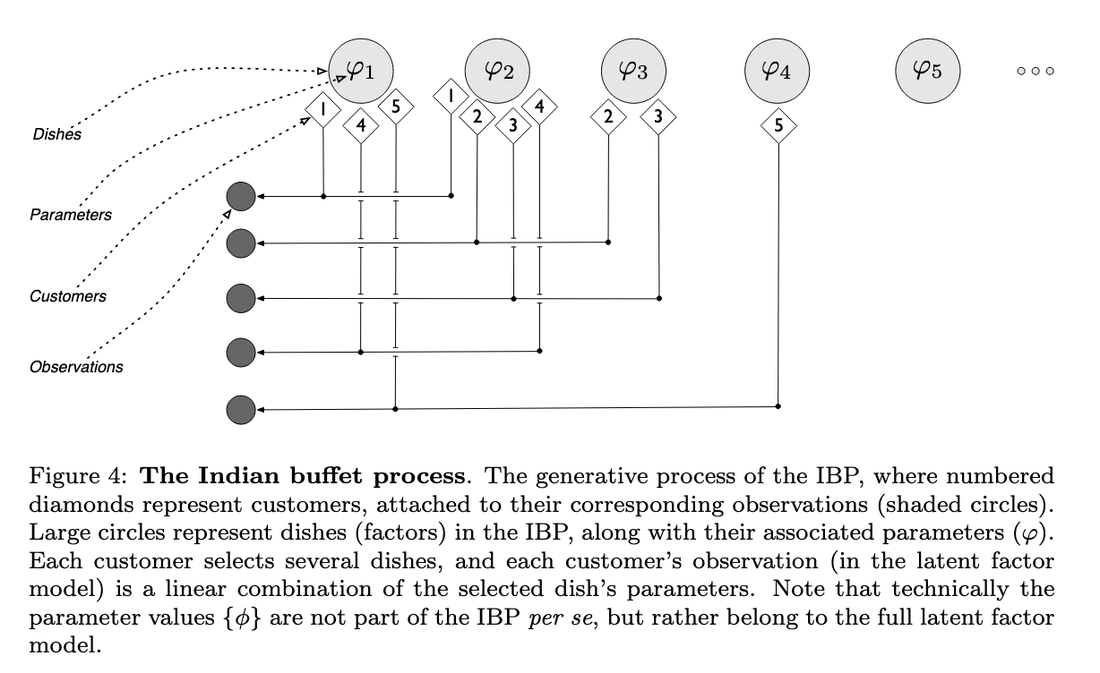
CRP: cada cliente se sienta en una mesa (una causa por observación). IBP: cada cliente toma varios platillos (varias causas activas a la vez).
En el Proceso del Buffet Indio cada observación es una combinación lineal de los parámetros de los platillos elegidos: un modelo de factores latentes con número infinito de factores.
Gershman, S. J., & Blei, D. M. (2012). A tutorial on Bayesian nonparametric models. Journal of Mathematical Psychology, 56(1), 1–12.
Parte II · Aprender estructura
El Proceso del Buffet Indio interactivo
Cada cliente recorre el buffet: prueba cada platillo ya servido con probabilidad mk/n (fracción de clientes anteriores que lo tomaron) y toma Poisson(α/n) platillos nuevos.
Resultado: una matriz binaria clientes × platillos con un número de columnas que crece con los datos (≈ α·log n)
A diferencia del CRP, una observación puede tener varias causas activas a la vez: un modelo de rasgos latentes, no de categorías
Los platillos tempranos son populares (“los ricos se hacen más ricos”, otra vez); los tardíos, raros
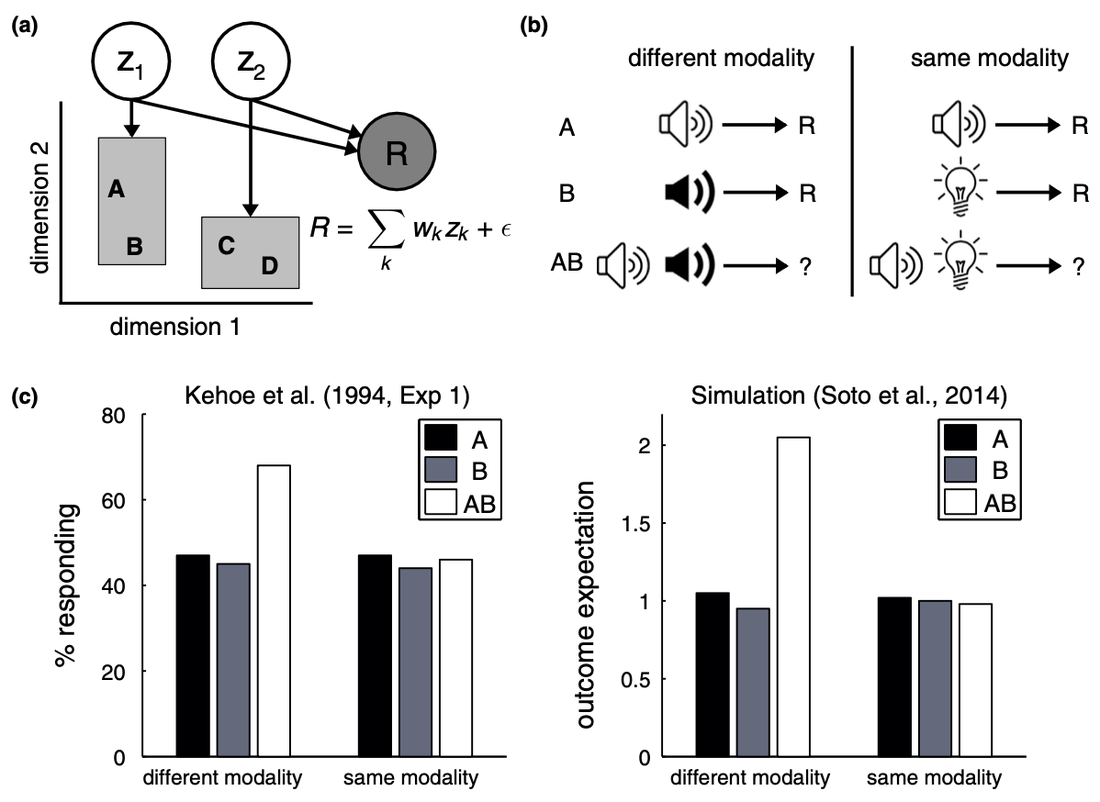
En condicionamiento: un compuesto AB puede activar las causas “A”, “B” y “contexto” a la vez (Soto et al., 2014)
Prueba
Griffiths, T. L., & Ghahramani, Z. (2011). The Indian buffet process: An introduction and review. JMLR, 12, 1185–1224. Gershman & Blei (2012).
Parte II · Aprender estructura
¿Dos pistas pertenecen a la misma “región de consecuencia”?
Cada causa tiene una “región de consecuencia” de la cual se muestrean las pistas
The size principle: regiones grandes resultan en likelihoods bajas
Pistas distintas más probablemente son asignadas a causas distintas
Predicción: la generalización compuesta (AB) depende de si A y B parecen venir de la misma causa
Soto, F. A., Gershman, S. J., & Niv, Y. (2014). Explaining compound generalization in associative and causal learning through rational principles of dimensional generalization. Psychological Review, 121(3), 526–558. Datos: Kehoe et al. (1994).
Parte II · Aprender estructura
El principio del tamaño interactivo
Una causa genera pistas uniformemente dentro de su región de consecuencia. Con n pistas, la verosimilitud de una región de área A que las contiene es (1/A)n; si no las contiene, 0.
Todas las regiones que contienen los datos son consistentes, pero la más pequeña es exponencialmente más probable, y la ventaja crece con n
Una sola pista lejana obliga a una región grande para “una causa”: la verosimilitud cae tanto que “dos causas” gana, aunque el prior CRP la castigue
Mismo principio que la generalización Bayesiana (Tenenbaum & Griffiths, 2001): pocos ejemplos parecidos → generalización estrecha
Prueba
Tenenbaum, J. B., & Griffiths, T. L. (2001). Generalization, similarity, and Bayesian inference. BBS, 24, 629–640. Soto, Gershman & Niv (2014).
Parte III · Juntar ambos
Predicciones sobre el tipo de extinción
¿Inferir una causa nueva o actualizar los parámetros de la misma causa?
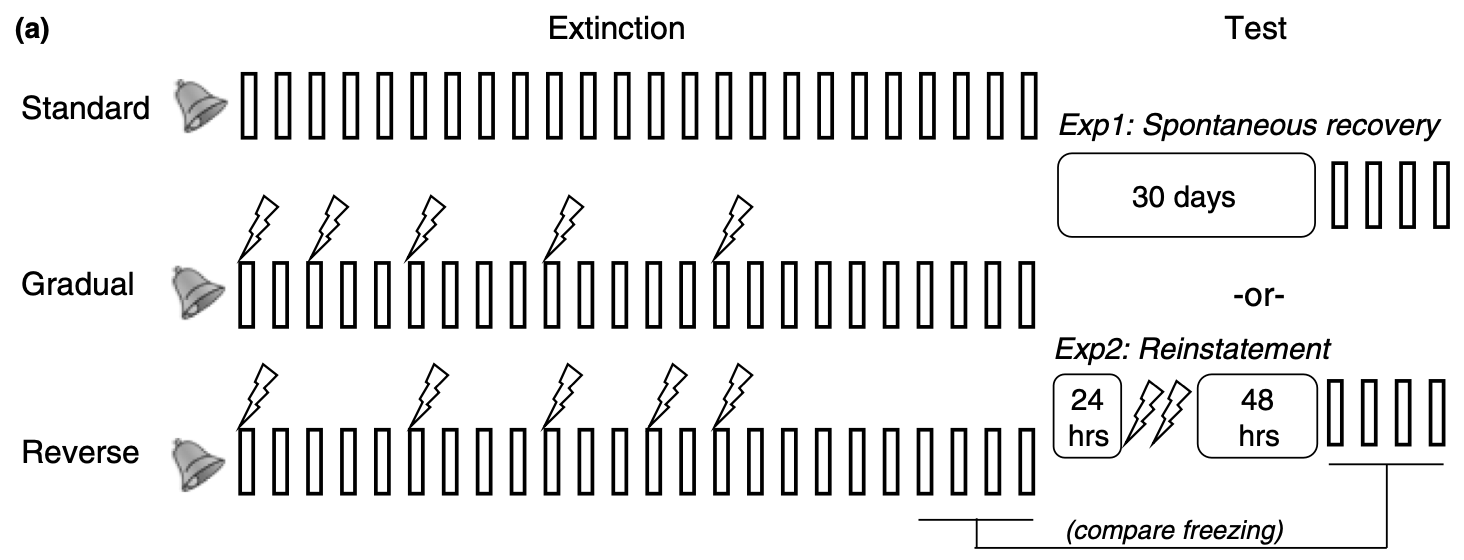
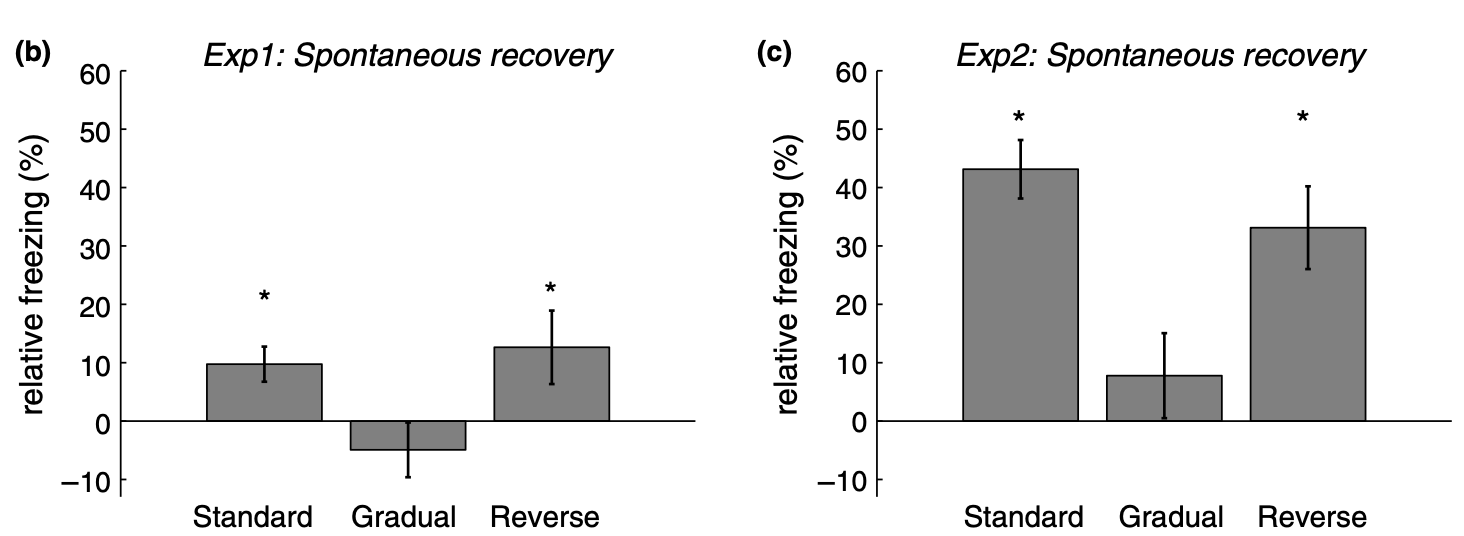
Si la extinción es abrupta: las observaciones son muy distintas → se infiere una causa nueva (“extinción”) y la causa original queda intacta → regresa el miedo
Si la extinción es gradual: las observaciones siguen pareciéndose a la adquisición → se actualiza la causa original → el miedo no regresa
Probabilidad de que regrese la respuesta: recuperación espontánea (30 días) y reinstalación (US solo)
Gershman, S. J., Jones, C. E., Norman, K. A., Monfils, M.-H., & Niv, Y. (2013). Gradual extinction prevents the return of fear. Frontiers in Behavioral Neuroscience, 7, 164.
Parte III · Juntar ambos
El modelo de causas latentes en acción interactivo
Prueba
αprior CRP: apetito por causas nuevasσcuánto puede desviarse el US de lo que la causa predice antes de ser “sorprendente”: σ pequeña → un ensayo sin US ya no cabe en la causa de adquisicióngmemoria del prior: el peso de un ensayo pasado decae como (Δt)−g; g grande → solo cuentan los ensayos recientes
Versión simplificada de Gershman et al. (2013): filtro de partículas, CRP sensible al tiempo, pesos Rescorla–Wagner por causa. 10 ensayos de adquisición, 24 de extinción, prueba a 30 días. Recuperación = P(US) en la prueba − al final de la extinción.
Parte III · Juntar ambos
Diseña tu propio protocolo de extinción interactivo
24 ensayos de extinción después de 10 de adquisición. Haz clic en un ensayo para poner o quitar el US (⚡). Luego simula y mira cuánto miedo regresa 30 días después.
Protocolos
Usa los mismos parámetros (α, σ, g) que la diapositiva anterior. Preguntas para explorar: ¿importa dónde caen los US o solo cuántos hay? ¿Qué pasa si los últimos ensayos tienen US? ¿Existe un protocolo con pocos US que evite el regreso del miedo?
Para discutir: en una terapia de exposición, ¿qué sería el equivalente de un US ocasional durante la extinción? ¿Qué predice el modelo para una exposición demasiado “limpia”?
Parte III · Juntar ambos
Síntesis: aprender valores y aprender estructura
Dos problemas, un solo error: el error de predicción (δ) actualiza el valor dentro de una causa, y la sorpresa acumulada decide si hace falta una causa nueva
No paramétrico: el número de estados no se fija de antemano; crece con los datos (CRP), y α regula el apetito por estados nuevos
Bayesiano: la asignación a causas es una creencia, no una decisión; el animal mantiene incertidumbre sobre “en qué situación estoy”
Consecuencias: la extinción no borra; crea. Por eso el miedo regresa, y por eso la extinción gradual lo evita
Nivel computacional: aprender en un mundo que cambia por tramos es inferir cuándo cambió
Próxima clase (mía): Aprendizaje y olvido en redes neuronales
Referencias
Gershman, S. J., & Blei, D. M. (2012). A tutorial on Bayesian nonparametric models. J. Math. Psychol., 56, 1–12.
Gershman, S. J., Blei, D. M., & Niv, Y. (2010). Context, learning, and extinction. Psychol. Rev., 117, 197–209.
Gershman, S. J., Jones, C. E., Norman, K. A., Monfils, M.-H., & Niv, Y. (2013). Gradual extinction prevents the return of fear. Front. Behav. Neurosci., 7, 164.
Gershman, S. J., Norman, K. A., & Niv, Y. (2015). Discovering latent causes in reinforcement learning. Curr. Opin. Behav. Sci., 5, 43–50.
Kamin, L. J. (1969). Predictability, surprise, attention, and conditioning. En Punishment and Aversive Behavior, 279–296.
Marr, D. (1982). Vision. W. H. Freeman.
Montague, P. R., Dayan, P., & Sejnowski, T. J. (1996). A framework for mesencephalic dopamine systems based on predictive Hebbian learning. J. Neurosci., 16, 1936–1947.
Redish, A. D., Jensen, S., Johnson, A., & Kurth-Nelson, Z. (2007). Reconciling reinforcement learning models with behavioral extinction and renewal. Psychol. Rev., 114, 784–805.
Rescorla, R. A., & Wagner, A. R. (1972). A theory of Pavlovian conditioning. En Classical Conditioning II, 64–99.
Schultz, W., Dayan, P., & Montague, P. R. (1997). A neural substrate of prediction and reward. Science, 275, 1593–1599.
Schultz, W. (2002). Getting formal with dopamine and reward. Neuron, 36, 241–263.
Soto, F. A., Gershman, S. J., & Niv, Y. (2014). Explaining compound generalization in associative and causal learning. Psychol. Rev., 121, 526–558.
Sutton, R. S. (1988). Learning to predict by the methods of temporal differences. Mach. Learn., 3, 9–44.
Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2ª ed.). MIT Press.
Watkins, C. J. C. H., & Dayan, P. (1992). Q-learning. Mach. Learn., 8, 279–292.